Kapitalizacja NVIDIA spadła o ponad 500 miliardów dolarów w ciągu jednego dnia handlowego. Tyle wystarczyło, żeby branża technologiczna zaczęła zadawać pytania, których wcześniej głośno nie formułowała: czy dotychczasowe założenia o tym, ile mocy obliczeniowej potrzeba do budowy najlepszych modeli językowych, są w ogóle trafne? DeepSeek – nowy gracz na rynku AI, który nieźle namieszał – pokazał, że wyniki porównywalne z GPT-4 można osiągnąć przy znacznie mniejszym zużyciu zasobów. To nie była zapowiedź, lecz działający model, udostępniony publicznie wraz z kodem źródłowym. Reakcja rynków była natychmiastowa, a dyskusja w środowisku programistów i analityków trwa do dziś. Poniżej zebrałem wszystkie wątki w jednym miejscu: skąd pochodzi DeepSeek, jak wypada w benchmarkach na tle GPT-4, co oznacza jego charakter open source i dlaczego geopolityka ma tu tyle samo do powiedzenia co inżynieria.
Chiński rodowód i państwowa polityka AI od 2017 roku
DeepSeek to chiński model językowy. Samo to zdanie wystarczy, żeby zrozumieć część kontekstu, bo Chiny prowadzą skoordynowaną politykę wspierania badań nad sztuczną inteligencją od 2017 roku. To nie jest spontaniczny ruch rynkowy, lecz efekt wieloletnich inwestycji państwowych w infrastrukturę badawczą, kształcenie kadr i finansowanie projektów z obszaru uczenia maszynowego.
Sukces DeepSeek jest wymiernym rezultatem tej polityki. Przez kilka lat zachodnie firmy, takie jak Google czy OpenAI, budowały przewagę opartą na dostępie do ogromnych klastrów obliczeniowych i kapitale prywatnym. Chiny odpowiedziały inaczej: postawiły na optymalizację architektury modeli i efektywność obliczeniową zamiast na wyścig o coraz większe zasoby sprzętowe. DeepSeek jest widocznym efektem tej strategii. Firma otwarcie udostępniła szczegóły techniczne swoich rozwiązań, co samo w sobie jest rzadkością wśród podmiotów z tak silnym zapleczem państwowym.
Warto mieć ten kontekst w głowie, analizując każdy kolejny aspekt tego modelu. Nie chodzi wyłącznie o jedną firmę, lecz o sygnał, że centrum ciężkości w globalnym wyścigu AI może się przesuwać.
Jak DeepSeek wypada na tle GPT-4?
DeepSeek stworzył model, który w benchmarkach dorównuje GPT-4, a w niektórych aspektach go przewyższa – przy znacznie mniejszym zużyciu zasobów obliczeniowych. To zdanie wymaga rozwinięcia, bo samo porównanie wyników bez kontekstu kosztów niewiele mówi.
Dotychczasowy schemat działania w branży był prosty: lepszy model wymaga więcej danych treningowych, więcej procesorów i więcej energii. DeepSeek zakwestionował tę zależność przez serię optymalizacji w architekturze modelu. Architektura została przeprojektowana tak, żeby wyciągać więcej z mniejszej liczby operacji obliczeniowych. Producent twierdzi, że efektywność osiągnięto bez obniżenia jakości odpowiedzi na zadania rozumowania, kodowania i analizy językowej.
W praktyce weryfikacja takich deklaracji wymaga czasu i niezależnych testów. To, co jest pewne: model działa, jest publicznie dostępny i można go sprawdzić samodzielnie. Dla programistów i badaczy to ważniejsze niż jakikolwiek komunikat prasowy. Bezpośrednie porównanie z GPT-4 na tych samych zadaniach jest możliwe, a wyniki – zależnie od kategorii zadań – bywają zaskakujące dla tych, którzy zakładali, że dominacja jednego dostawcy jest trwała.
Open source jako punkt zwrotny dla rynku
Model udostępniono jako open source – co oznacza, że publicznie dostępny jest zarówno kod źródłowy, jak i wiedza o konstrukcji architektury. To decyzja, która zmienia rachunek dla każdego, kto chciał budować własne rozwiązania oparte na dużych modelach językowych, ale hamowały go koszty licencji lub brak dostępu do technologii.
Obniżenie barier wejścia dla nowych podmiotów to jeden z najbardziej konkretnych skutków pojawienia się DeepSeek na rynku. Mały zespół programistów, uczelnia badawcza czy firma z ograniczonym budżetem mogą teraz wziąć model, przejrzeć jego architekturę, dostosować go do własnych potrzeb i uruchomić bez opłat licencyjnych. To nie jest tylko kwestia oszczędności – to zmiana strukturalna w tym, kto może uczestniczyć w tworzeniu produktów opartych na AI.
Demokratyzacja dostępu do zaawansowanych modeli językowych ma też drugą stronę. Otwartość kodu oznacza, że każdy może zbadać, jak model działa, wykryć jego słabości i – co ważne – zidentyfikować potencjalne luki bezpieczeństwa. To argument za transparentnością, lecz takze za tym, że odpowiedzialne wdrażanie otwartych modeli wymaga świadomości ryzyk, a nie tylko entuzjazmu wobec niskich kosztów.
Reakcja rynków: 500 miliardów dolarów w jeden dzień
Kapitalizacja NVIDIA spadła o ponad 500 miliardów dolarów w ciągu jednego dnia handlowego po tym, jak DeepSeek trafił na pierwsze strony raportów branżowych. To jeden z największych jednodniowych spadków wartości firmy w historii rynków finansowych i najlepszy wskaźnik tego, jak poważnie inwestorzy potraktowali implikacje tego modelu.
Logika jest prosta. Jeśli podobne lub lepsze wyniki można osiągnąć przy mniejszej mocy obliczeniowej, to przyszły popyt na specjalistyczne procesory AI – czyli główne źródło przychodów NVIDIA w ostatnich latach – może być niższy, niż zakładały prognozy. Analitycy zaczęli rewidować modele wzrostu firm technologicznych, które budowały swoją wycenę na założeniu, że wyścig o coraz większe klastry GPU będzie trwał bez końca.
Co to oznacza dla firm i programistów?
Pytanie o praktyczne konsekwencje pojawienia się DeepSeek jest ważniejsze niż debata o tym, kto ma lepszy model. Dla firm, które dopiero planują wdrożenie AI, sytuacja stała się czytelniejsza: wybór nie ogranicza się już do kilku dużych dostawców z zamkniętymi API i nieprzejrzystą polityką cenową.
Poniżej cztery scenariusze, w których otwarta architektura DeepSeek zmienia rachunek ekonomiczny:
- Programista budujący asystenta do analizy dokumentów prawnych może pobrać model, uruchomić go lokalnie i dostosować do konkretnego przypadku użycia – bez negocjowania kontraktu z OpenAI ani Google;
- Firma z sektora ochrony zdrowia może przetwarzać dane pacjentów na własnej infrastrukturze, eliminując ryzyko wycieku przez zewnętrzne serwery;
- Uczelnia badawcza z ograniczonym budżetem może prowadzić eksperymenty na pełnowymiarowym modelu bez opłat licencyjnych;
- Startup testujący produkt AI może obniżyć koszty zapytań od kilku do kilkudziesięciu razy w porównaniu z komercyjnymi API – zależnie od skali projektu.
Ile można zaoszczędzić?
Różnica w kosztach między lokalnym wdrożeniem a korzystaniem z komercyjnych API może wynosić od kilku do kilkudziesięciu razy, zależnie od skali projektu i częstotliwości zapytań. Dla projektu generującego milion zapytań miesięcznie to różnica, która decyduje o rentowności całego przedsięwzięcia.
Compliance jako argument
Dla firm z sektorów regulowanych, takich jak bankowość czy administracja publiczna, lokalny model to konkretny argument w rozmowach z działem compliance. Dane nie opuszczają infrastruktury, co eliminuje całą klasę ryzyk związanych z przetwarzaniem wrażliwych informacji przez zewnętrzne serwery.
Czy DeepSeek jest bezpieczny?
To pytanie pojawia się regularnie i zasługuje na rzeczową odpowiedź, bez paniki ani nadmiernego optymizmu. Model pochodzi z Chin, co automatycznie uruchamia dyskusję o możliwości zbierania danych użytkowników lub wbudowanych mechanizmach cenzury.
Kilka faktów. Wersja hostowana przez DeepSeek – dostępna przez przeglądarkę lub API – podlega chińskiemu prawu i regulacjom dotyczącym treści. Testy przeprowadzone przez niezależnych badaczy wykazały, że model odmawia odpowiedzi na pytania dotyczące wydarzeń politycznie wrażliwych z perspektywy Chin, na przykład dotyczących wydarzeń na placu Tiananmen. To cenzura wbudowana w model, a nie efekt uboczny.
Natomiast wersja open source, uruchomiona lokalnie na własnej infrastrukturze, jest pod tym względem inna. Użytkownik ma pełną kontrolę nad modelem i danymi. Kilka organizacji badawczych potwierdziło, że lokalne wdrożenia nie wysyłają danych do zewnętrznych serwerów. Pytanie o bezpieczeństwo sprowadza się więc do konkretnego pytania: z jakiej wersji korzystasz i na czyjej infrastrukturze?
Chiński model a regulacje w Europie
Europa patrzy na DeepSeek przez dwa osobne pryzmaty. Pierwszy to Akt o sztucznej inteligencji (AI Act), który wchodzi w życie etapami od 2024 roku i nakłada obowiązki na dostawców oraz wdrażających systemy AI w UE. Drugi to geopolityka i pytanie o to, czy systemy AI z państw trzecich powinny podlegać dodatkowym wymogom.
Z punktu widzenia AI Act, DeepSeek jako model ogólnego przeznaczenia podlega obowiązkom dokumentacyjnym i ocenie ryzyka – podobnie jak modele OpenAI czy Google. Fakt, że producent ma siedzibę poza UE, nie zwalnia z tych wymogów, jeśli model jest używany na terenie Unii. To oznacza, że firmy wdrażające DeepSeek w europejskim środowisku produkcyjnym muszą przeprowadzić własną ocenę zgodności, niezależnie od tego, co deklaruje producent.
Kilka europejskich organów nadzorczych już zapowiedziało analizę modelu pod kątem RODO, szczególnie w odniesieniu do wersji hostowanej. Włochy jako pierwsze ograniczyły dostęp do tej wersji, powołując się na brak jasnych informacji o tym, gdzie i jak są przetwarzane dane użytkowników. To precedens, który może zostać powtórzony w innych krajach.
DeepSeek a przyszłość wyścigu o AI
Pojawienie się DeepSeek pokazało jedną rzecz wyraźniej niż cokolwiek wcześniej: przewaga w tej dziedzinie nie jest trwała i nie wynika wyłącznie z wielkości budżetu. Model wytrenowany za ułamek kosztów konkurencji osiąga porównywalne wyniki – i to zmienia kalkulację dla wszystkich uczestników rynku.
Duże firmy technologiczne zareagowały dwutorowo. Część przyspieszyła prace nad własnymi otwartymi modelami, traktując DeepSeek jako sygnał, że zamknięte ekosystemy mogą tracić na atrakcyjności. Inne zdecydowały się na obniżenie cen API – koszt zapytania do GPT-4 spadł kilkukrotnie w ciągu miesięcy po premierze DeepSeek, co trudno uznać za zbieżność.
Wyścig o AI nie kończy się. Zmienia się jednak jego logika: z prostego „kto wyda więcej” na „kto znajdzie lepszą architekturę”. To dobra wiadomość dla podmiotów, które nie dysponują budżetami rzędu miliardów dolarów.
DeepSeek – nowy gracz na rynku AI, który zmienia reguły gry
Ocena DeepSeek zależy od tego, z jakiej perspektywy patrzysz. Dla inwestora to sygnał ostrzegawczy wobec firm, których wycena opierała się na założeniu, że koszt trenowania modeli będzie rósł bez końca. Dla programisty to narzędzie, które można dziś pobrać, uruchomić i sprawdzić. Dla regulatora to nowe wyzwanie w obszarze, który dopiero uczy się oceniać ryzyko.
Jedno jest wspólne dla każdego z tych punktów widzenia: DeepSeek nie jest zjawiskiem przejściowym. Model istnieje, działa i jest dostępny publicznie – co oznacza, że jego wpływ na ekosystem AI będzie trwał niezależnie od tego, co stanie się z firmą lub jej kolejnymi wersjami.
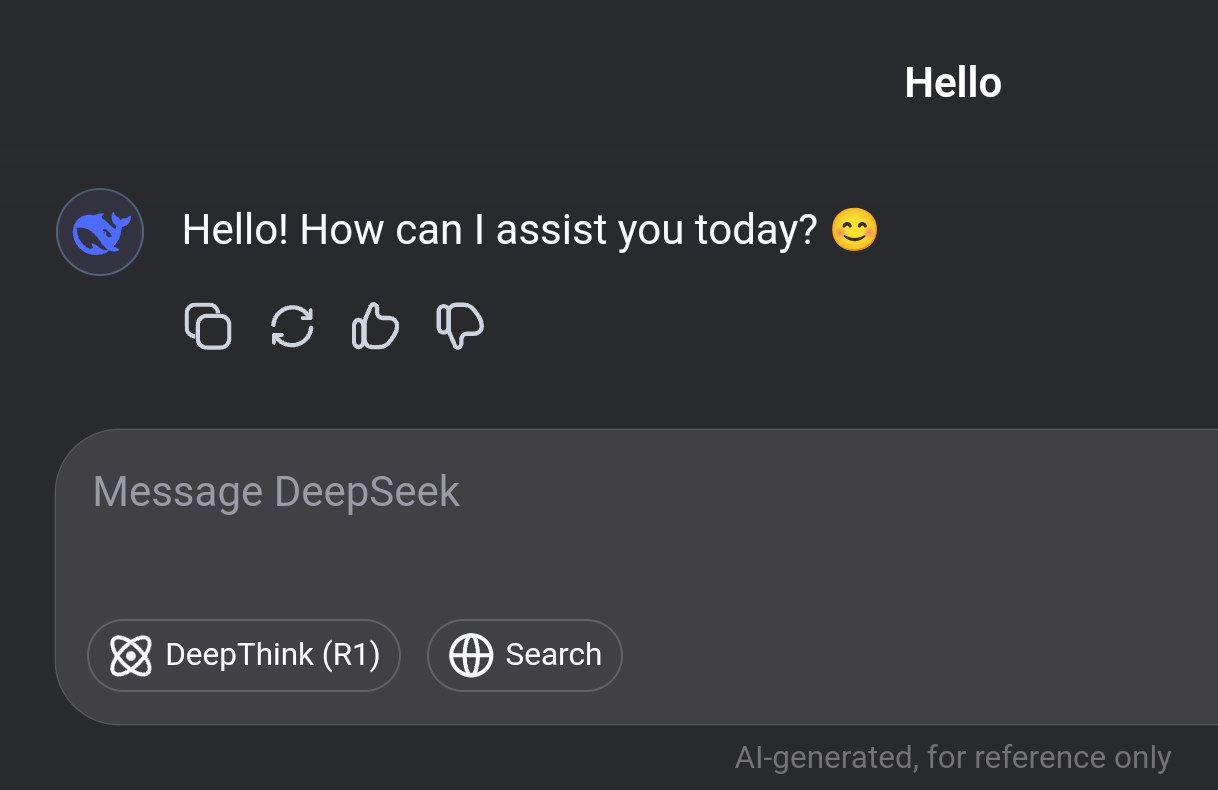
Jeśli chcesz wyrobić sobie własną opinię, najlepszą metodą jest bezpośredni test. Weź konkretne zadanie, które regularnie wykonujesz z pomocą innego modelu, i uruchom je na DeepSeek – zarówno w wersji hostowanej, jak i lokalnej, jeśli masz taką możliwość. Różnice w jakości odpowiedzi, szybkości i zachowaniu modelu przy trudnych pytaniach powiedzą więcej niż jakikolwiek benchmark.